В новостях пишут: «модель на 70 миллиардов параметров», «OpenAI выложила открытые веса». Звучит так, будто все вокруг понимают, о чем речь. На самом деле за этим стоит очень простая идея.
Веса — это числа внутри нейросети. Каждое показывает, насколько сильно один сигнал влияет на результат. Все, чему модель научилась, хранится именно в этих числах.
Ниже — пример на одной заявке из CRM, откуда берутся веса, что значит 7B и 70B и что такое открытые веса.
Что такое веса в нейросети простыми словами
Вес — это множитель на связи между двумя нейронами. Сигнал проходит по связи и умножается на вес: большой вес усиливает сигнал, маленький ослабляет, отрицательный переворачивает.
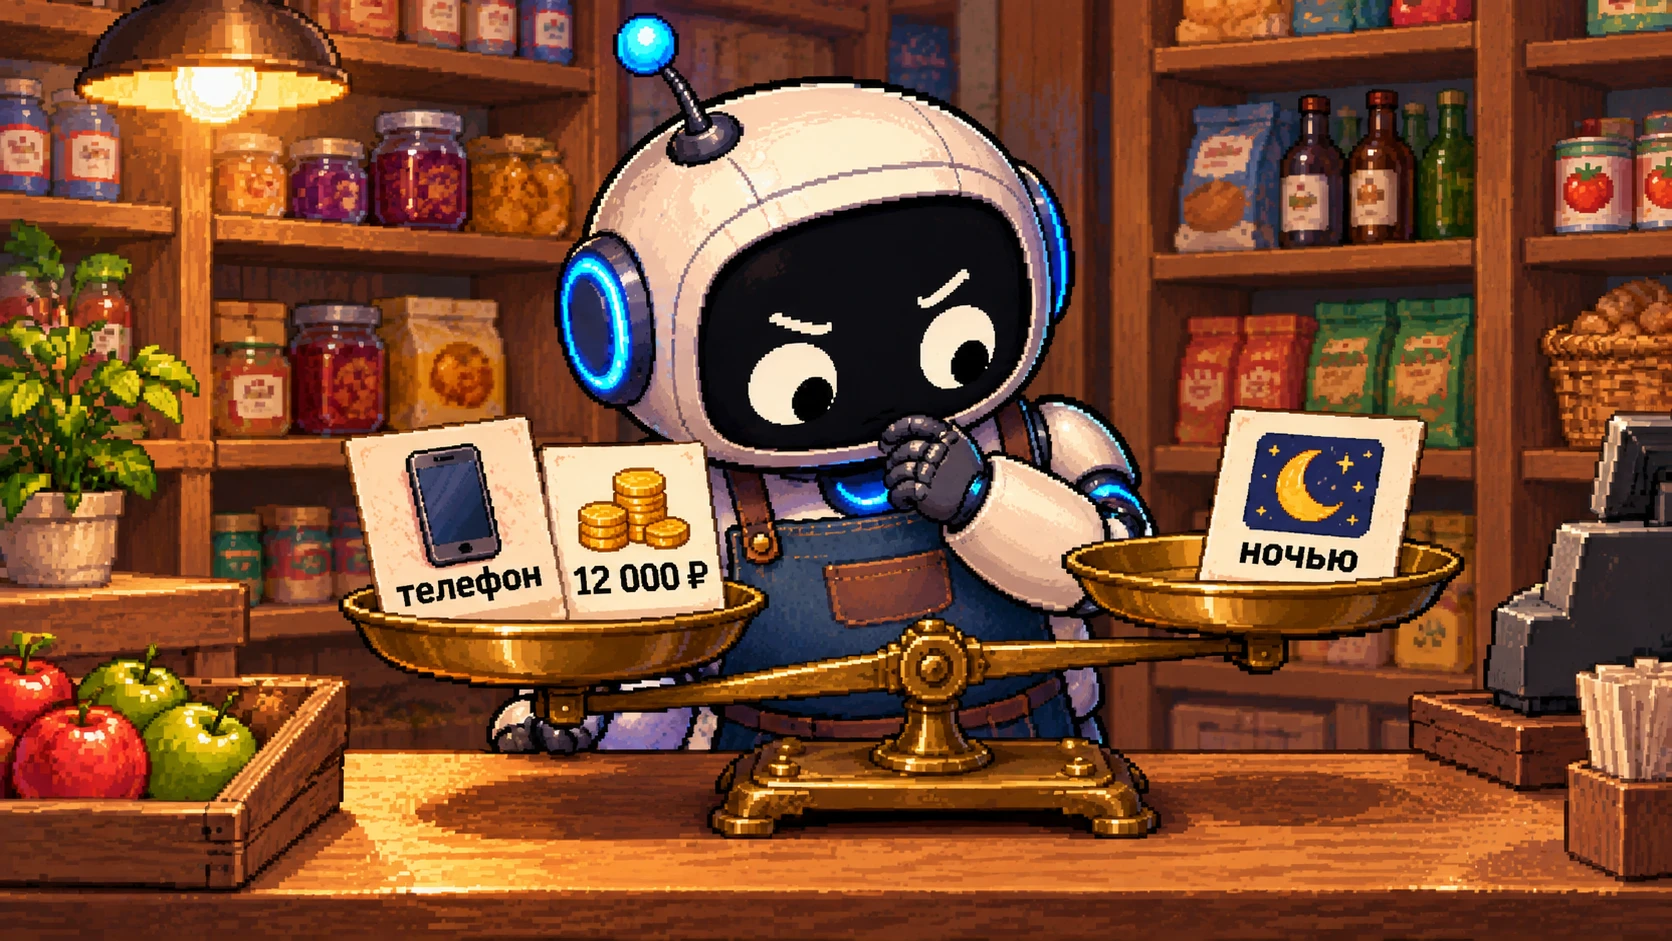
Проще всего понять это через опытного менеджера по продажам. Он смотрит на новую заявку и за секунду решает, перезвонить сразу или потом. В голове у него — набор «весов»: оставил телефон — важно, сумма корзины большая — тоже важно, пришел из рекламы — так себе, написал в три часа ночи — скорее минус.
Менеджер не записывает эти веса, они сложились из опыта. У нейросети все то же самое, только веса — это конкретные числа, и их миллиарды.
Как работают веса: пример на заявке
Возьмем самую простую нейросеть — один нейрон. Его задача — оценить, купит ли клиент, который оставил заявку в интернет-магазине.
На вход нейрон получает четыре признака. Каждый — либо 1 (да), либо 0 (нет). У каждого признака свой вес:
| Признак | Значение | Вес | Вклад |
|---|---|---|---|
| Оставил телефон | 1 | 2,0 | 2,0 |
| Корзина больше 5000 ₽ | 1 | 1,5 | 1,5 |
| Пришел из рекламы | 0 | 0,5 | 0 |
| Написал ночью | 1 | −1,0 | −1,0 |
| Сумма | 2,5 |
Нейрон умножает каждый признак на его вес и складывает. Получилось 2,5. Дальше к сумме добавляется смещение — еще одно число, которое задает порог. Пусть оно равно −1,5. Итог: 2,5 − 1,5 = 1,0. Больше нуля — значит, заявка горячая, звоним первой.
Как один нейрон принимает решение
Признаки
телефонкорзинарекламаночьУмножить на веса и сложить
2,0 + 1,5 + 0 − 1,0 − 1,5 = 1,0
Решение
больше нуля — горячая заявка
Посмотрите на веса как на мнение нейрона о мире. Телефон с весом 2,0 — самый сильный сигнал. Ночное сообщение с весом −1,0 работает против покупки. Реклама с весом 0,5 почти ничего не решает.
В настоящих нейросетях таких нейронов тысячи, они собраны в слои, и выход одного слоя становится входом следующего. Но каждый нейрон делает то же самое: умножает на веса, складывает, передает дальше.
Веса и смещения: в чем разница
Вес отвечает за то, насколько важен конкретный входной сигнал. Смещение (bias) — за то, насколько нейрон в целом «легок на подъем».
В примере выше смещение −1,5 значит: «по умолчанию я скептик, убеди меня». Если поставить смещение +1, нейрон будет считать горячей почти любую заявку.
Смещения тоже подбираются при обучении. Вместе с весами их называют параметрами модели. Смещений на порядки меньше, чем весов, поэтому в разговоре «веса» и «параметры» обычно означают одно и то же.
Откуда берутся веса: обучение
Веса никто не прописывает руками. В начале обучения это случайные числа, и нейросеть ошибается почти всегда. Потом начинается цикл, который повторяется миллионы раз.
Как нейросеть подбирает веса
Прогноз
считает ответ на текущих весах
Ошибка
сравнивает с правильным ответом
Поправка
чуть сдвигает каждый вес, чтобы ошибка уменьшилась
Повтор
следующий пример
Вернемся к заявкам. Допустим, у нас есть история из 10 000 заявок, и про каждую известно, купил клиент или нет. Нейросеть смотрит на заявку, говорит «купит с вероятностью 30 %», а клиент купил. Значит, веса признаков, которые были в этой заявке, нужно немного поднять.
Направление и размер поправки для каждого веса вычисляет алгоритм обратного распространения ошибки, а сам спуск к меньшей ошибке называется градиентным спуском. Математика там серьезная, но смысл простой: каждый вес двигают туда, где ошибка меньше, маленькими шагами.
После тысяч таких поправок веса перестают меняться. Например, вес «оставил телефон» вырос до 2,0, потому что такие клиенты действительно покупали чаще. Нейросеть сама нашла закономерность, которую менеджер выучил за годы работы.
Веса — это и есть знания модели
Отдельной базы фактов внутри нейросети нет. Когда ChatGPT знает, что Казань стоит на Волге, этот факт не записан строчкой в таблице. Он размазан по огромному числу весов, и ни один из них по отдельности ничего не значит.
Поэтому нейросеть так сложно «прочитать». Исследователи только учатся находить внутри модели понятия. В 2024 году Anthropic показала, что в Claude 3 Sonnet можно найти миллионы таких понятий — например, признак, который срабатывает на мост Золотые Ворота. Когда его искусственно усилили, модель начала называть мостом саму себя.
По-моему, это лучший ответ на вопрос «понимает ли нейросеть». Она не хранит текстов и правил. Она хранит веса, которые так настроены, что на выходе получаются осмысленные ответы. И даже ее создатели пока видят внутри лишь отдельные фрагменты.
Веса и параметры: сколько их
Число параметров — главная характеристика размера модели. Его пишут прямо в названии: Llama 3.1 8B, Qwen 72B. Буква B значит billion, миллиард.
| Модель | Год | Параметров |
|---|---|---|
| AlexNet — распознавание изображений | 2012 | около 60 млн |
| GPT-3 | 2020 | 175 млрд |
| Llama 3.1 405B | 2024 | 405 млрд |
| DeepSeek-V3 | 2024 | 671 млрд, из них на каждый токен работают 37 млрд |
За 12 лет — рост в десять тысяч раз. Сколько параметров у GPT-5, Claude и Gemini, неизвестно: компании это больше не раскрывают.
Обратите внимание на DeepSeek. Современные большие модели часто устроены как смесь экспертов (MoE): весов много, но на каждый ответ включается только их часть. Так модель знает много, а работает быстро.
Больше параметров — не всегда лучше. Я бы не выбирал модель по этой цифре. Модели на 7–8 млрд параметров 2024 года на стандартных тестах знаний обходят GPT-3 с ее 175 млрд — их просто лучше обучили, на большем объеме и более качественных данных.
Сколько весят веса нейросети
Веса хранятся в обычных файлах, и их размер легко прикинуть: число параметров умножить на размер одного числа.
- В 16-битном формате каждый вес занимает 2 байта. Модель на 7 млрд параметров весит около 14 ГБ.
- После квантования — сжатия чисел до 4 бит — та же модель занимает около 4 ГБ и запускается на обычном ноутбуке.
Квантование немного снижает точность, но для большинства задач разница незаметна. Например, OpenAI пишет, что ее открытая модель gpt-oss-20b на 21 млрд параметров работает в пределах 16 ГБ памяти именно благодаря сжатию весов.
Файлы весов обычно имеют формат .safetensors (для запуска через библиотеки вроде Transformers) или .gguf (для программ вроде LM Studio и Ollama).
Что такое открытые веса
Модель с открытыми весами (open weights) — это модель, файлы весов которой выложены в открытый доступ. Их можно скачать и запустить на своем компьютере или сервере.
Открытые веса — не то же самое, что открытый исходный код. Обычно публикуют только сами веса, а данные, на которых модель училась, и код обучения остаются закрытыми. Пользоваться моделью можно, а воспроизвести ее с нуля — нет.
| Закрытая модель | Открытые веса | |
|---|---|---|
| Примеры | ChatGPT, Claude, Gemini | Llama, Qwen, DeepSeek, gpt-oss |
| Где работает | На серверах компании | Где угодно, в том числе у вас |
| Данные | Уходят разработчику | Остаются у вас |
| Дообучение | Ограничено | Полное |
Для бизнеса главный плюс открытых весов — данные никуда не уходят. Если нужно разбирать договоры или переписку с клиентами, которые нельзя отправлять в чужое облако, модель можно поднять на своем сервере.
Но я бы не начинал с этого. Свой сервер с видеокартой — это деньги и обслуживание, а лучшие закрытые модели по-прежнему умнее открытых. Открытые веса имеют смысл, когда есть жесткое требование к данным или очень большой поток однотипных задач.
Дообучение: как поменять веса под себя
Раз знания модели — это веса, то научить ее новому значит поменять веса. Это называется дообучением (fine-tuning): готовую модель доучивают на своих примерах, например на тысяче ответов вашей поддержки.
Переобучать все миллиарды весов дорого. Поэтому чаще используют LoRA: основные веса замораживают и обучают маленькую надстройку поверх них. По данным авторов метода, для GPT-3 это сокращает число обучаемых параметров в 10 000 раз.
С LoRA вы, скорее всего, уже сталкивались, если генерировали картинки. Файлы LoRA для Stable Diffusion и FLUX, которые добавляют модели нужный стиль или персонажа, — это как раз такие маленькие наборы весов.
Веса в промпте — это другое
У слова «вес» в нейросетях есть второе значение, и его легко перепутать с первым. В генераторах изображений можно задать вес части промпта — насколько сильно модель должна на нее опираться.
- В Stable Diffusion:
(закат:1.3)— усилить,(закат:0.7)— ослабить. - В Midjourney:
закат::2 город::1— закат вдвое важнее города.
Эти веса не меняют саму модель. Они только расставляют акценты в конкретном запросе. Про отрицательные веса и запреты в промптах есть отдельная статья — что такое негативный промпт.
Мой итог
Если запомнить одну мысль: нейросеть — это архитектура плюс веса. Архитектура задает, как числа перемножаются и складываются. Веса — что модель знает. Все остальное — обучение, дообучение, открытые модели, размер в гигабайтах — вытекает из этого.
На практике это знание нужно в двух ситуациях. Когда выбираете модель, «70B» перестает быть магией: это размер, а не качество. А когда думаете о собственной модели, становится понятно, что дообучение — это не «загрузить документы», а поменять веса на своих примерах. Чаще всего бизнесу хватает готовой модели и хорошего промпта с базой знаний.
Если хотите понять, какая модель и какой подход подойдут под ваши задачи — закрытая через API, открытая на своем сервере или готовый сервис, — с этим я помогаю: AI-ассистенты и автоматизация. А если хочется глубже в устройство, почитайте, какие бывают нейросети и как они понимают смысл через эмбеддинги.